
 VIP会员


11月4日上午,乌镇。中国信息通信研究院与华为、阿里巴巴、腾讯、百度、蚂蚁集团、火山引擎、小米、OPPO、荣耀等20家单位,在一份只有八条的《智能体发展自律公约》上签了字。同一场论坛上,信通院副院长敖立透露了一个更具体的事实:智能体标识身份网络已经上线,北京、厦门、重庆三地可信互联中心开始运行。
听起来离生意很远。但把它放进一个具体场景,问题立刻变硬:当采购经理把"比价、议价、下单"三件事交给一个智能体,供应商的系统凭什么相信这个智能体是谁、代表哪家公司、能签多大的单?过去三年,产业界把资源都押在"模型够不够强"上;而当AI从"回答"走向"办事",真正卡住落地的是身份、权限与账单。
01 八条公约里,最硬的是前两条
这份公约不是凭空出现的。据公开报道,2026年5月,国家网信办、国家发展改革委、工业和信息化部联合印发《智能体规范应用与创新发展实施意见》,其中"强化行业自律"一项任务,落到了这份八条公约上。所以它虽然有"自律"两个字,实际是政策链条的一环,不是行业内部的君子协定。
八条依次是:健全智能体信任体系、建设智能体互联基础设施、提升智能体互操作水平、提升智能体安全防护能力、健全智能体治理机制、保护智能体用户权益、加速智能体赋能千行百业、推动智能体技术普惠共享。后四条偏原则,前四条才是需要动手的部分。
第一条要求"建立分层次、可验证的智能体身份标识",并完善身份验证与管理、权限授予与控制、规则表达与内嵌等机制——文件里把它称作"信任锚点"。第二条要求共建"注册与解析、能力描述与发现、意图理解与转换、网络路由与连接、资源调度与计量、协议兼容与互认"六类技术与标准。
这六个词组,把互联网三十年的老剧本又演了一遍。注册与解析,对应DNS;身份标识,对应CA证书与实名体系;协议兼容与互认,对应TCP/IP;资源调度与计量,对应运营商的计费系统。区别在于:域名解析错一次,用户刷新一下页面;智能体身份认错一次,可能是几十万的订单、一批货的交付、一次不合规的数据外发。
小结论:智能体互联的第一性问题不是"能不能连上",而是"连上之后敢不敢授权"。能连是技术问题,敢授权是制度问题。
02 Token的增速,已经把"人工审核"这条路堵死了
为什么是2026年11月,而不是更早或更晚?答案藏在调用量里。
国际数据公司(IDC)发布的《中国AI软件市场半年度追踪,26H1》显示,2026年上半年中国MaaS市场按营收口径达到106.3亿元,同比增长889.4%;按调用量口径,全市场Token消耗量达到2857.9万亿,同比增长约432.5%。IDC把增长归因于模型升级、场景放量、模态扩容三条。
把2857.9万亿摊到181天,是每天约15.8万亿Token。这个量级意味着什么?假设有人想用人工方式确认"每一次调用是不是被授权的",哪怕按每次审核只用1分钟算,需要的审核工时也是任何企业都无法承担的。安全团队再扩编十倍,也追不上这条曲线。
与此同时,供给端在加速膨胀。阿里巴巴董事会主席蔡崇信在乌镇表示,千问系列已开源超470款模型,全球累计下载量突破40亿次。模型越多、越便宜,企业就越倾向于把"选模型"这件事交给系统自动完成——这恰恰是最需要身份与权限控制的环节。
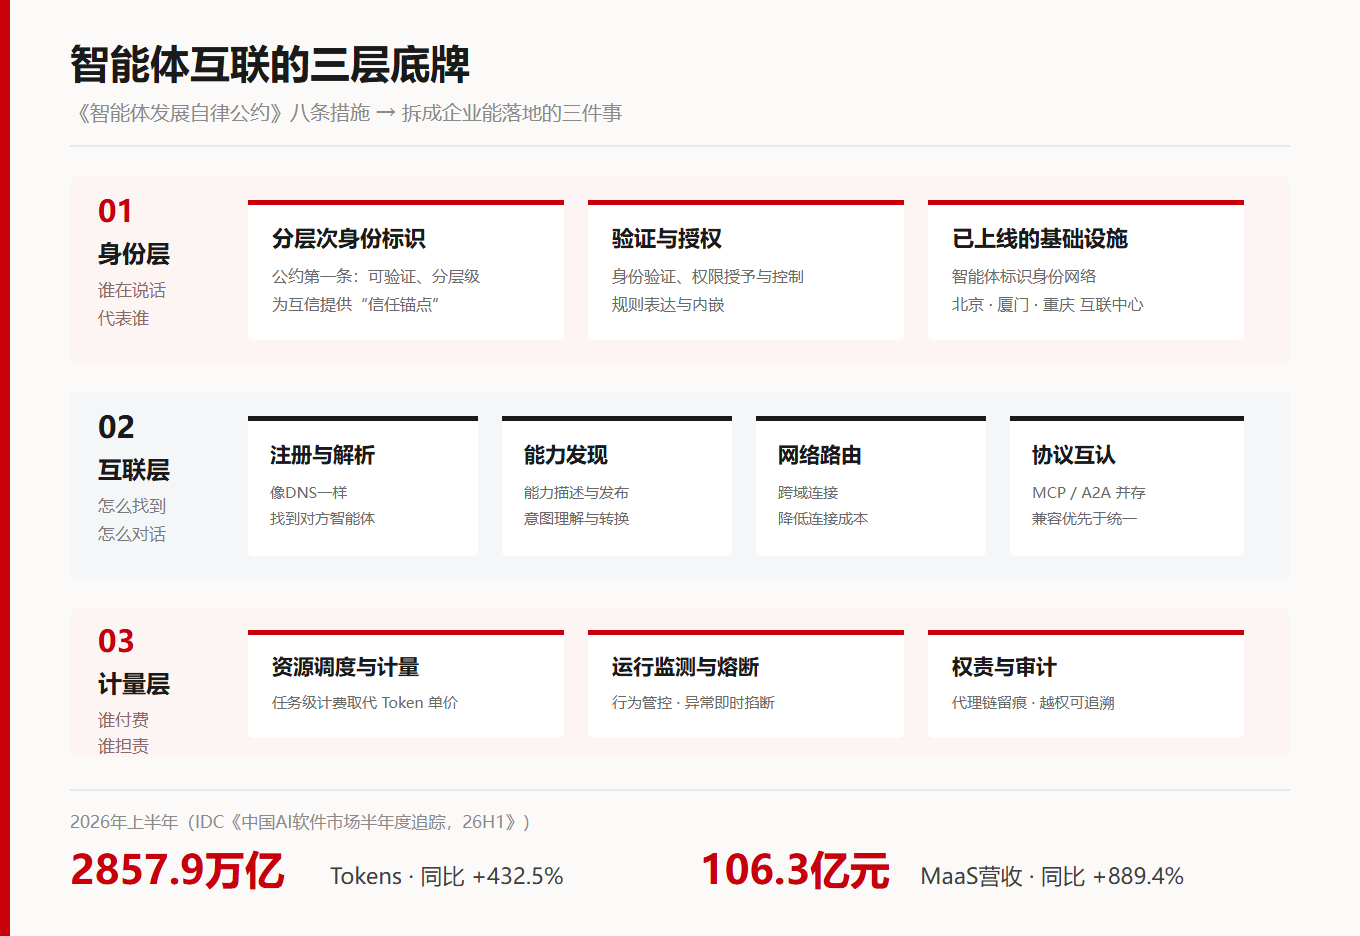
▲ 智能体互联的三层底牌(依据《智能体发展自律公约》八条措施整理)
这里有一个容易被忽略的因果:Token价格在下降,调用量在爆炸,两个方向叠加,结果是"单次调用的价值变低,但单次调用的风险不变"。人工去管每一次低价值调用,成本远高于收益;可一旦不管,越权、外泄、错误下单的后果又要企业自己承担。唯一的出路是把审核规则写进系统,让机器去验机器。
小结论:当调用量级越过人审阈值,身份和计量就不再是"可选项",而是必须提前铺好的基础设施。
03 "计量"被写进公约,意味着智能体开始有账单
第二条里那四个字——"资源调度与计量",是整份文件里最像商业条款、也最少被讨论的部分。它要解决的问题很朴素:智能体A调用智能体B,谁付钱、按什么计价、账单怎么对。
一条典型的企业间调用链长这样:采购方的比价智能体发起询价,供应商的报价智能体给出阶梯价与账期,物流智能体返回运力与时效,最后回到采购侧的审批智能体生成合同草稿。四个智能体,分属三家公司,跑在两家云上。这条链今天技术上跑得通——MCP负责接工具,A2A负责智能体之间对话——但账怎么记、责怎么分,还没有共识。
云计算早期也经历过同样的混乱:按量计费、包年包月、预留实例,各家口径不一,企业财务对不上账,最后靠一批标准化产品和第三方成本管理工具才理清。智能体的计费单位比云资源更碎——不是"一台虚拟机跑多久",而是"一个任务走了几步、调了几次工具、消耗了多少Token"。计量颗粒度越细,对账难度越高。
公约第四、第五条把配套的约束也写上了:健全前瞻性风险评估、运行监测、行为管控、异常熔断等技术体系;共同抵制利用智能体实施算法压榨、黑灰产等行为。熔断这个词很关键——它默认了一个前提:智能体一定会出错,所以必须有一条能随时掐断的线。
小结论:智能体的商业化终点,不会是"一百万Token多少钱",而是"办成一件事多少钱"。谁能把任务级计量做清楚,谁就掌握了定价权。
04 企业要改的是接入顺序,不是采购清单上的型号
过去两年,企业上AI的标准动作是:选模型、做POC、接API、上线。公约出来之后,这个顺序需要倒过来。
▍第一步:先定"谁能代表公司说话"
给每个对外运行的智能体一个唯一身份,绑定它代表的主体、可调用的工具、金额与数据权限的上限。这件事本质上不是IT项目,是授权制度的数字化——和给员工开权限、给印章定用途是同一件事。差别在于,员工的权限一年审一次,智能体的权限可能一天变三次。
▍第二步:把协议收敛到一层网关
MCP、A2A、各家私有协议会长期并存,这是现实。企业能做的是不要在业务代码里直接写协议调用,而是收拢到一层网关:进来的是意图,出去的是标准化请求,中间由网关负责鉴权、限流、留痕、计费。协议换代时改网关,不改业务。
▍第三步:审计日志和熔断阈值,与模型选型同级别立项
要能回答三个问题:这个动作是谁授权的、调用了哪些外部服务、花了多少钱。答不上来,一旦出事就无法界定责任。很多企业把日志当成运维副产品,等到要举证时才发现记的东西不对。
对山东的企业,这套顺序的价值比沿海互联网公司更直接。外贸、农产品集采、供应链金融这三类业务,天然是"多主体、跨企业、强履约"的场景——一笔订单要在工厂、货代、报关、银行之间流转,参与方各自系统不同、信任基础薄弱。智能体互联要解决的"跨域发现连接成本",在这里就是实打实的沟通成本与对账成本。谁能先把身份与凭证打通,谁就能把询价到交付的周期压下来。
平台侧的配套也在跟上。据公开报道,华为云的智能体开发平台AgentArts、代码智能体CodeArts已经接入自研模型能力,并兼容第三方SOTA模型——这种"一个平台挂多种模型、多个智能体"的形态,正是身份与计量体系要发挥作用的地方。没有身份层,平台越大越难管。
小结论:智能体项目的失败,多数不是因为模型不够聪明,而是因为没人说得清"它凭什么能做这件事"。
05 风险提示:四个容易踩空的坑
① 自律不等于强制:八条公约没有罚则,违规成本取决于商业信誉而非法律后果。跨平台互联在相当长时间内仍要靠双边谈判,指望"签了公约就能互通"会失望。
② 身份标识的隐私边界:智能体的能力描述里往往包含客户名单、报价策略、库存水平等敏感信息。标识体系设计不当,等于给竞争对手开了一个查询接口。企业接入前应明确哪些字段必须脱敏。
③ 代理链的责任真空:A委托B、B再委托C,出错时谁赔?现行法律框架下,智能体没有主体资格,责任最终落在委托人身上。多级委托必须逐级留痕、逐级授权,不能一句"系统自动的"了事。
④ 计量口径的黑箱:试用期免费、正式期账单跳涨,是SaaS时代的老剧本。智能体按任务计费时,"一个任务"的边界由平台定义,企业很难复核。签约时应约定可审计的计量明细,而不是只看总价。
回到乌镇那间会议室。20家单位签下的八条,看起来是行业自律,实际是为下一阶段划了一条起跑线:互联网的上半场连接信息,下半场连接智能体,而连接智能体的前提,是先给它们一个可验证的身份。这件事没有发布会上的参数好看,也没有模型榜单刺激,但它决定了三年后企业的AI预算究竟花在"试用"上,还是花在"生产"上。
对云厂商,这是一次把竞争从"模型参数"拉回"基础设施"的机会;对企业,这是一次把AI项目从"演示"推入"流程"的机会;而对山东这样以制造、农业、外贸为基本盘的省份,这甚至是一次难得的对齐机会——本地产业最需要的从来不是最强的智能体,而是最不容易出错、最容易被审计的那一个。
本文基于公开资料整理,仅作产业分析,不构成投资建议。
数据来源:《智能体发展自律公约》全文(中国信通院,2026年11月4日)、2026年世界互联网大会乌镇峰会公开报道、IDC《中国AI软件市场半年度追踪,26H1》、中国信通院公开披露